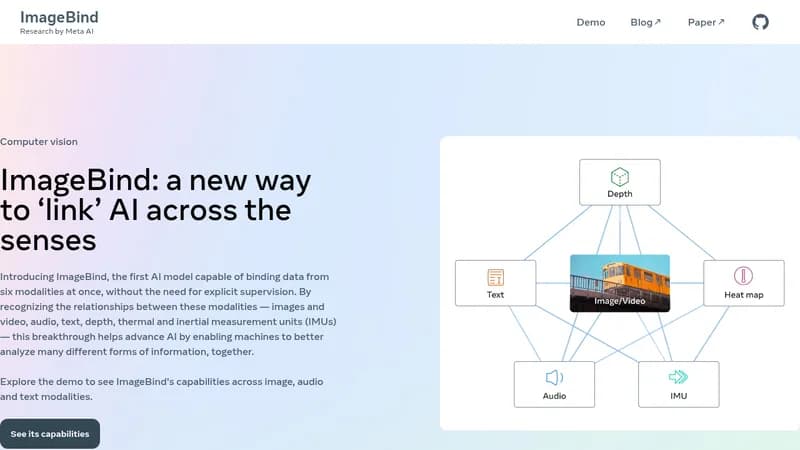
ImageBind is an AI model from Meta AI that learns a single embedding space to bind data from six modalities: images and video, audio, text, depth, thermal, and inertial measurement units (IMUs). It achieves this without the need for explicit supervision, enabling emergent zero-shot and few-shot recognition across modalities. The model can upgrade existing AI models to support input from any of the six modalities, enabling capabilities such as audio-based search, cross-modal search, multimodal arithmetic, and cross-modal generation. ImageBind is open source and achieves state-of-the-art performance on emergent zero-shot recognition tasks across modalities, outperforming prior specialist models trained specifically for those modalities.
Key Features
- Binds six modalities: images/video, audio, text, depth, thermal, IMUs
- Single embedding space without explicit supervision
- Enables zero-shot and few-shot recognition
- Supports cross-modal search, multimodal arithmetic, and cross-modal generation
- Open source
Use Cases
- Audio-based search
- Cross-modal search
- Multimodal arithmetic
- Cross-modal generation
Key Benefits
- Binds six modalities in a single embedding space
- Achieves state-of-the-art zero-shot recognition
- Open source and extensible to existing models